
Модель за два цента и модель за доли цента — кто увидит на картинке больше? Мы прогнали двадцать vision-моделей через OpenRouter на одной специально собранной картинке и сравнили не «красоту текста», а два рабочих навыка: понять сцену и попасть боксом в нужный объект.
Для сервисов вроде Ypage это практичный вопрос. Когда ИИ смотрит референс сайта, скрин интерфейса или кадр ролика, важнее не красноречие, а точность: что там есть и где именно.
Смотрите тесты на YouTube: https://youtu.be/gQJBGBMPtIc?si=6z8IWBPBMiwqDoLr
Какую картинку дали моделям
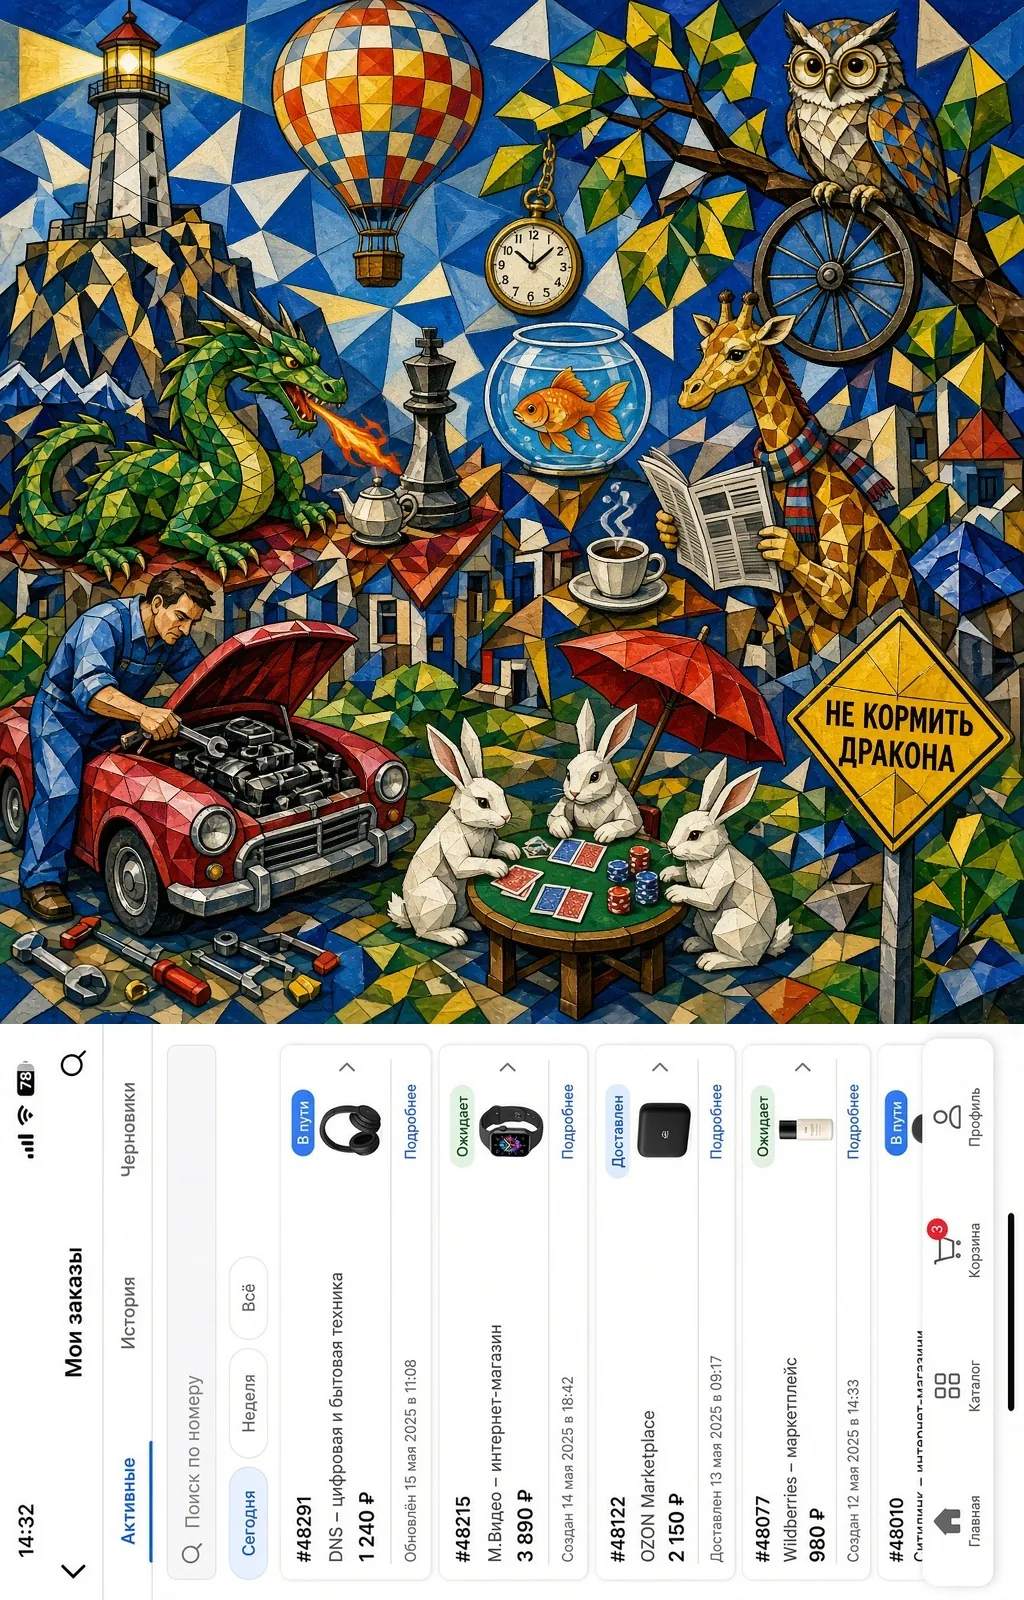
Сверху — сюрреалистичный коллаж: много независимых сцен в одном кадре. Снизу — мобильный UI со списком заказов, намеренно повёрнутый. Так мы проверяем и «художественное» зрение, и работу со скрином.
Как тестировали
Как в работе — два шага, а не «обведи всё подряд».
Describe. Короткий вопрос: «Что на картинке?» Ответ — свободный текст. Сверяли с чеклистом из 15 пунктов: дракон, текст знака, кролики, карты, механик, машина, жираф, сова, маяк, шар, рыба, UI, поворот экрана, плашка часов и другие детали.
Ground. Просим найти только четыре цели и вернуть JSON с боксами
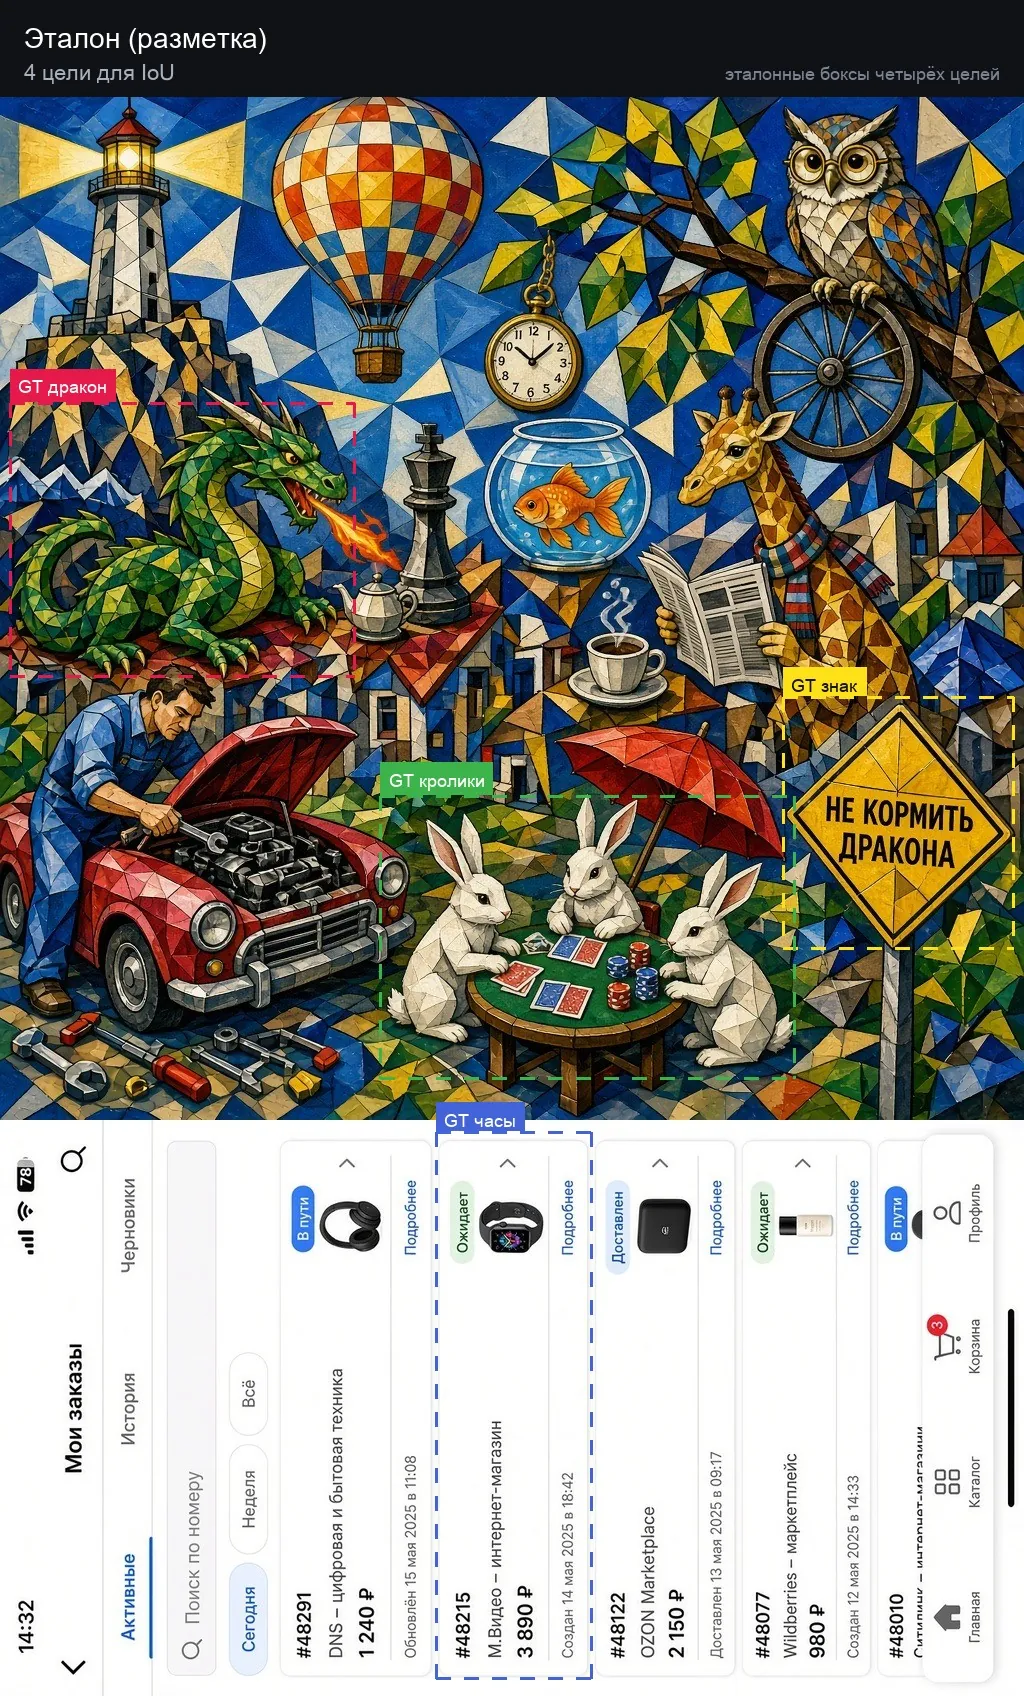
box_2dв координатах от 0 до 1000: зелёный дракон, жёлтый знак «НЕ КОРМИТЬ ДРАКОНА», кролики за столом, плашка товара «часы» (М.Видео) в списке заказов. Эталон разметили вручную и считали IoU — насколько бокс модели совпал с эталоном.
Формат ответа на ground выглядел так:
{"label": "watch_card", "box_2d": [x_min, y_min, x_max, y_max]}Координаты — в шкале 0–1000 по ширине и высоте кадра. Вот эталон: пунктирные рамки на четырёх целях.
В сетку вошли линейки OpenAI, Google, Anthropic, Qwen, DeepSeek, Meta, плюс Grok, GLM и Mistral. Запросы шли чанками по пять, с запасом по токенам. Две модели на момент теста не дали vision-ответ на роутере и в рейтинг не вошли. Осмысленный пакет describe + ground на всю сетку обошёлся примерно в $0.20; с отладкой стимула и промптов — ближе к $0.40.
Тест Describe: кто понял сцену
На «что на картинке?» восемнадцать моделей дали развёрнутый ответ. Полный чеклист 15 из 15 закрыли сразу несколько участников — и дорогих, и очень дешёвых:
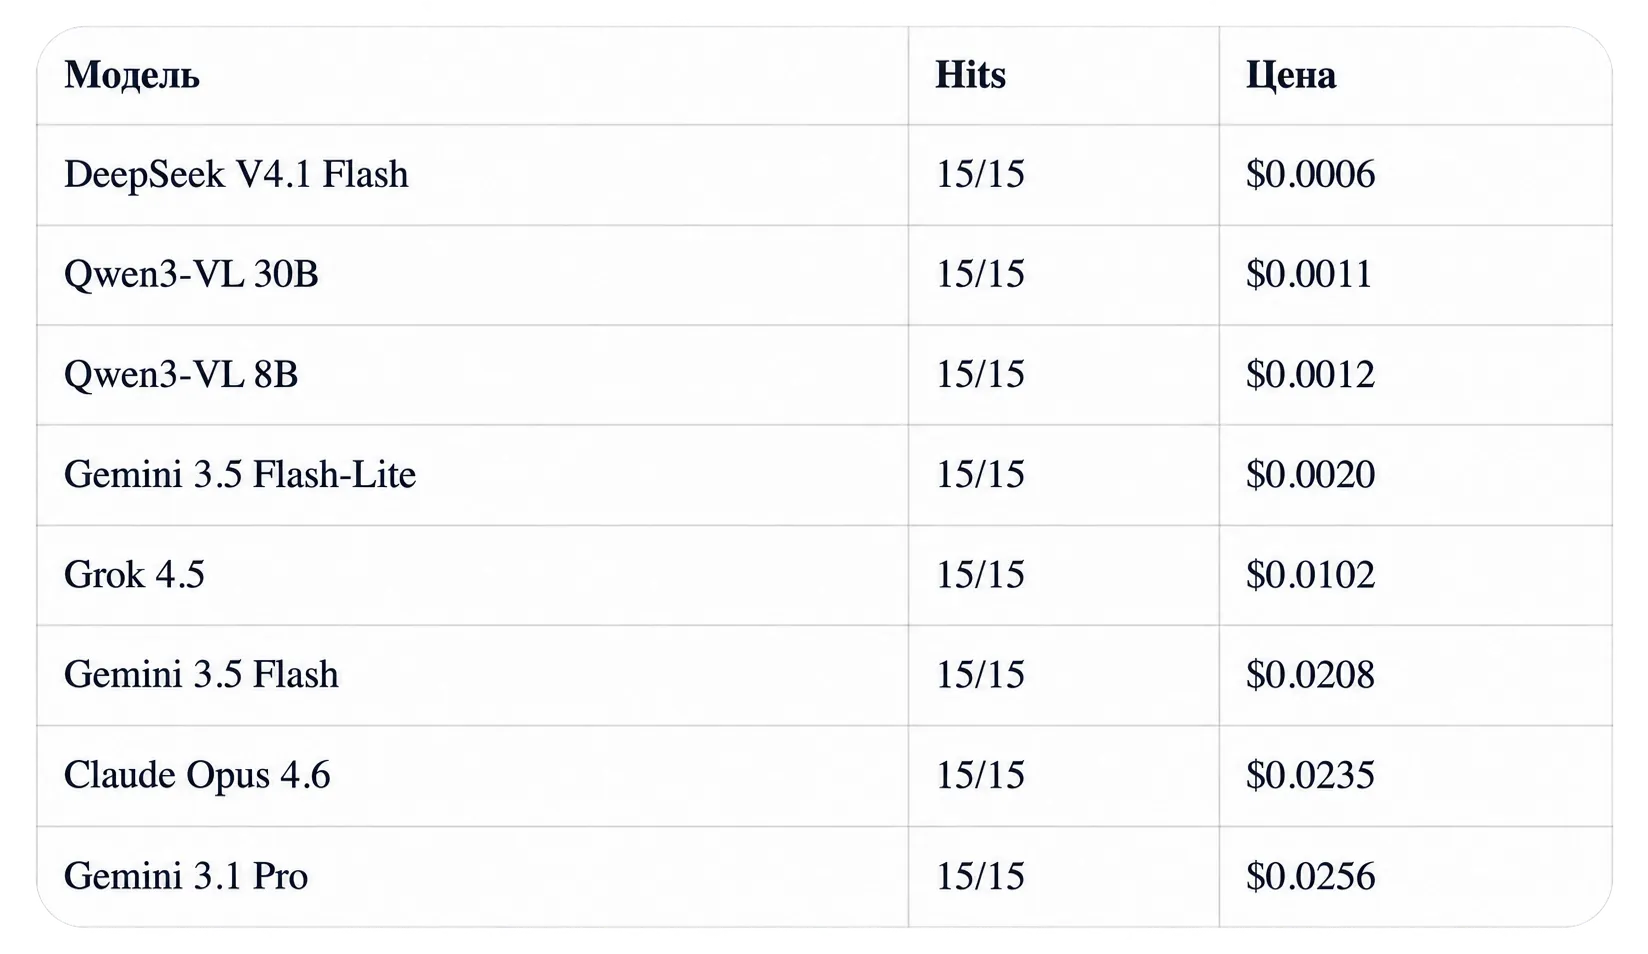
Чуть ниже — 14/15 у Luna, Llama 4 Maverick, Qwen 235B, Sonnet и Sol; 13/15 у Scout, GLM-4.6v, Luna Pro и Haiku; 12/15 у самого дешёвого GLM-5.3 Flash.
Интерфейс заказов заметили почти все. А вот явно сказать, что экран повёрнут, смогли только 8 из 18. Текст знака «НЕ КОРМИТЬ ДРАКОНА» прочитали почти все, кто дошёл до полного ответа.
На перегруженной сцене дешёвые Flash и VL закрывают чеклист не хуже Opus и Pro. Qwen 8B на осмотре выглядит сильнее более крупного и дорогого Qwen 235B — размер линейки тоже не гарантия.
Тест Ground: кто попал в объект
Описать сцену и обвести нужную плашку в UI — разные игры. Здесь считали средний IoU по целям на финальном эталоне. Четыре цели включали и жёлтый знак; по нему стабильного IoU почти ни у кого не вышло — в таблице и на кадрах ниже показываем объекты, где скор читается уверенно: дракон, кролики, часы.
Три лидера рядом: пунктир — эталон, сплошная — ответ модели, на рамке — IoU.
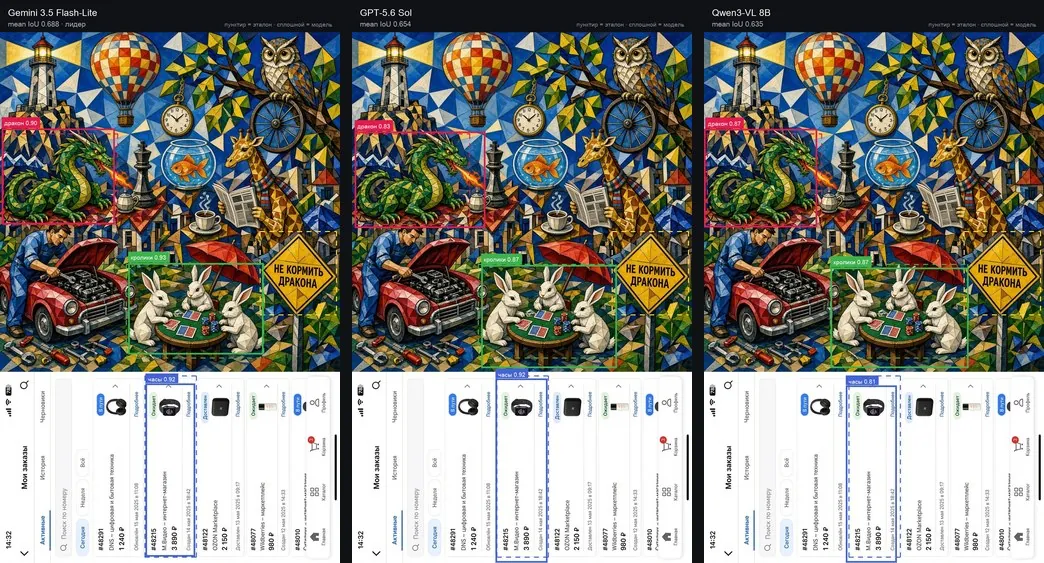
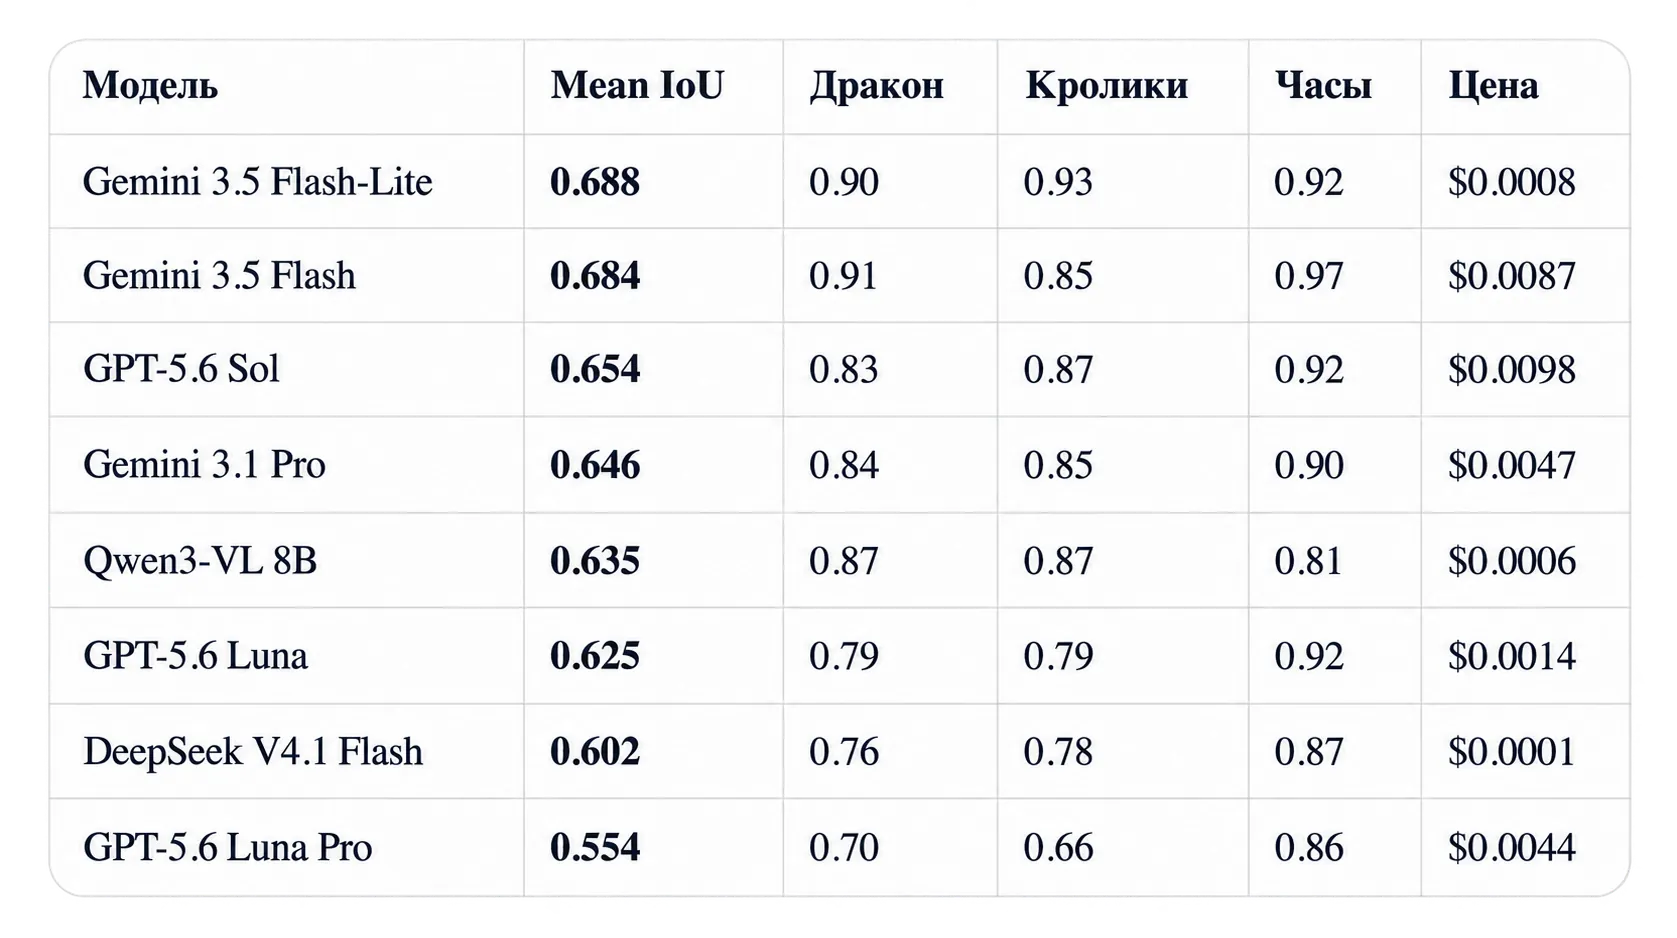
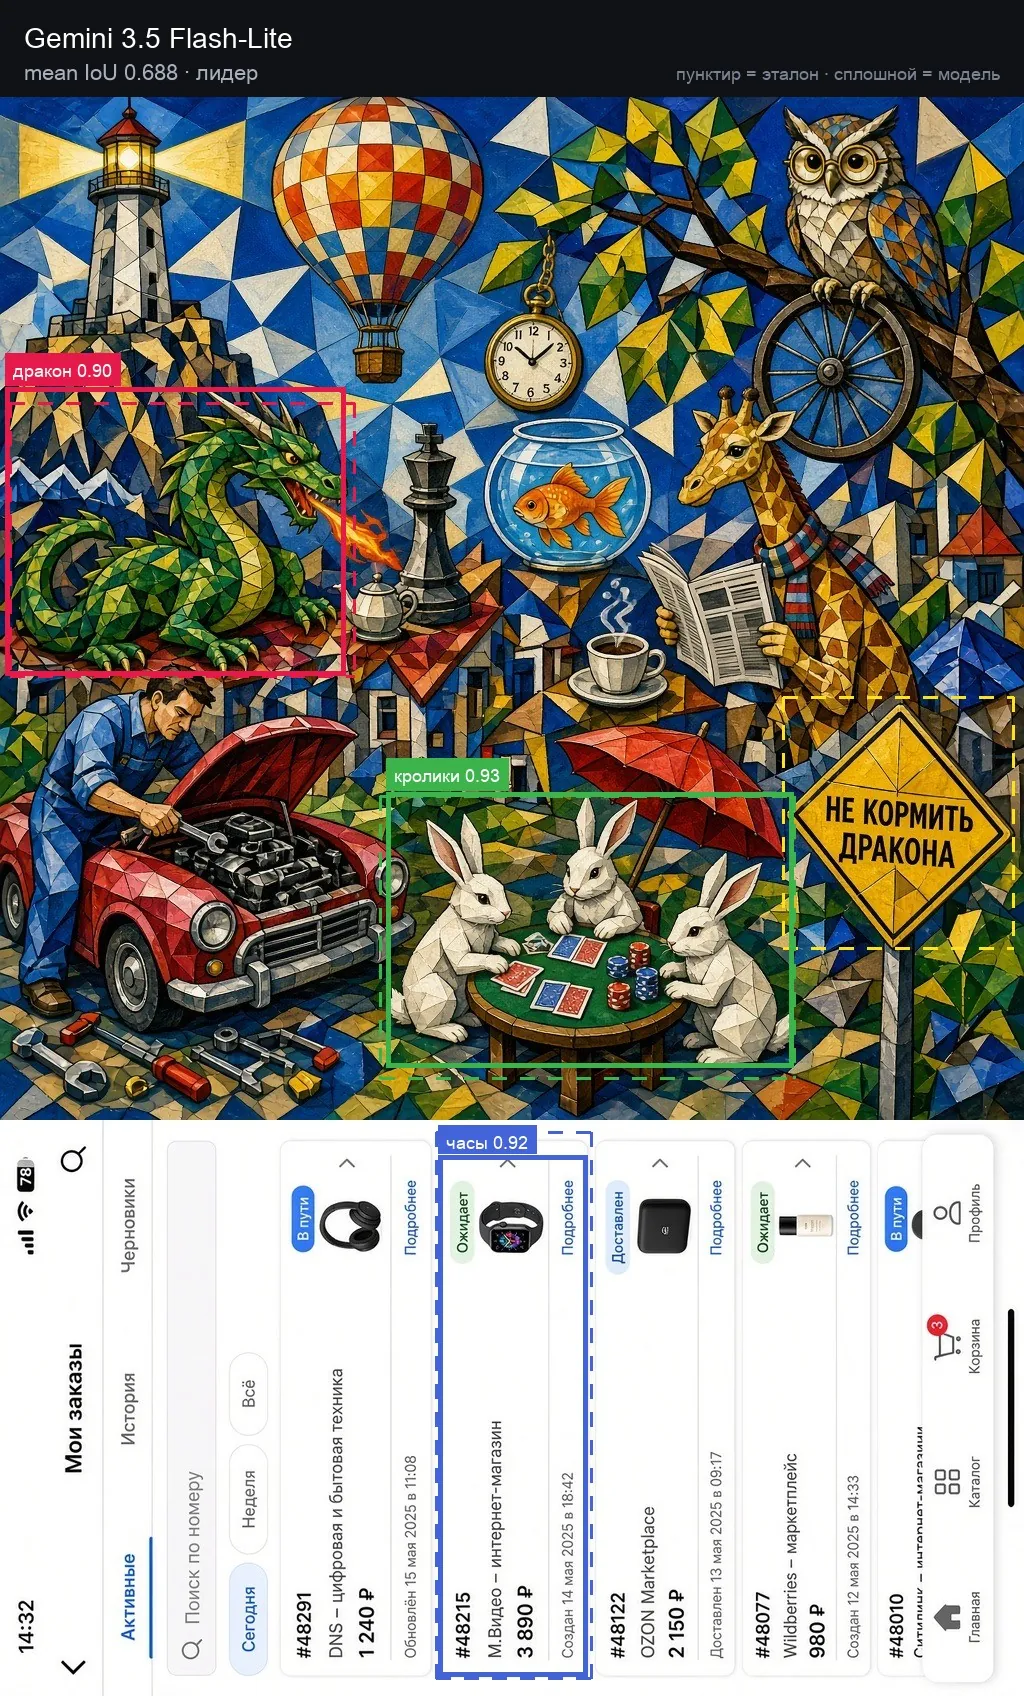
У лидеров плашка часов в списке заказов почти всегда на месте: IoU 0.81–0.97. Дракон и кролики тоже держатся уверенно. Крупнее — ответ Flash-Lite: рамки почти совпадают с эталоном.
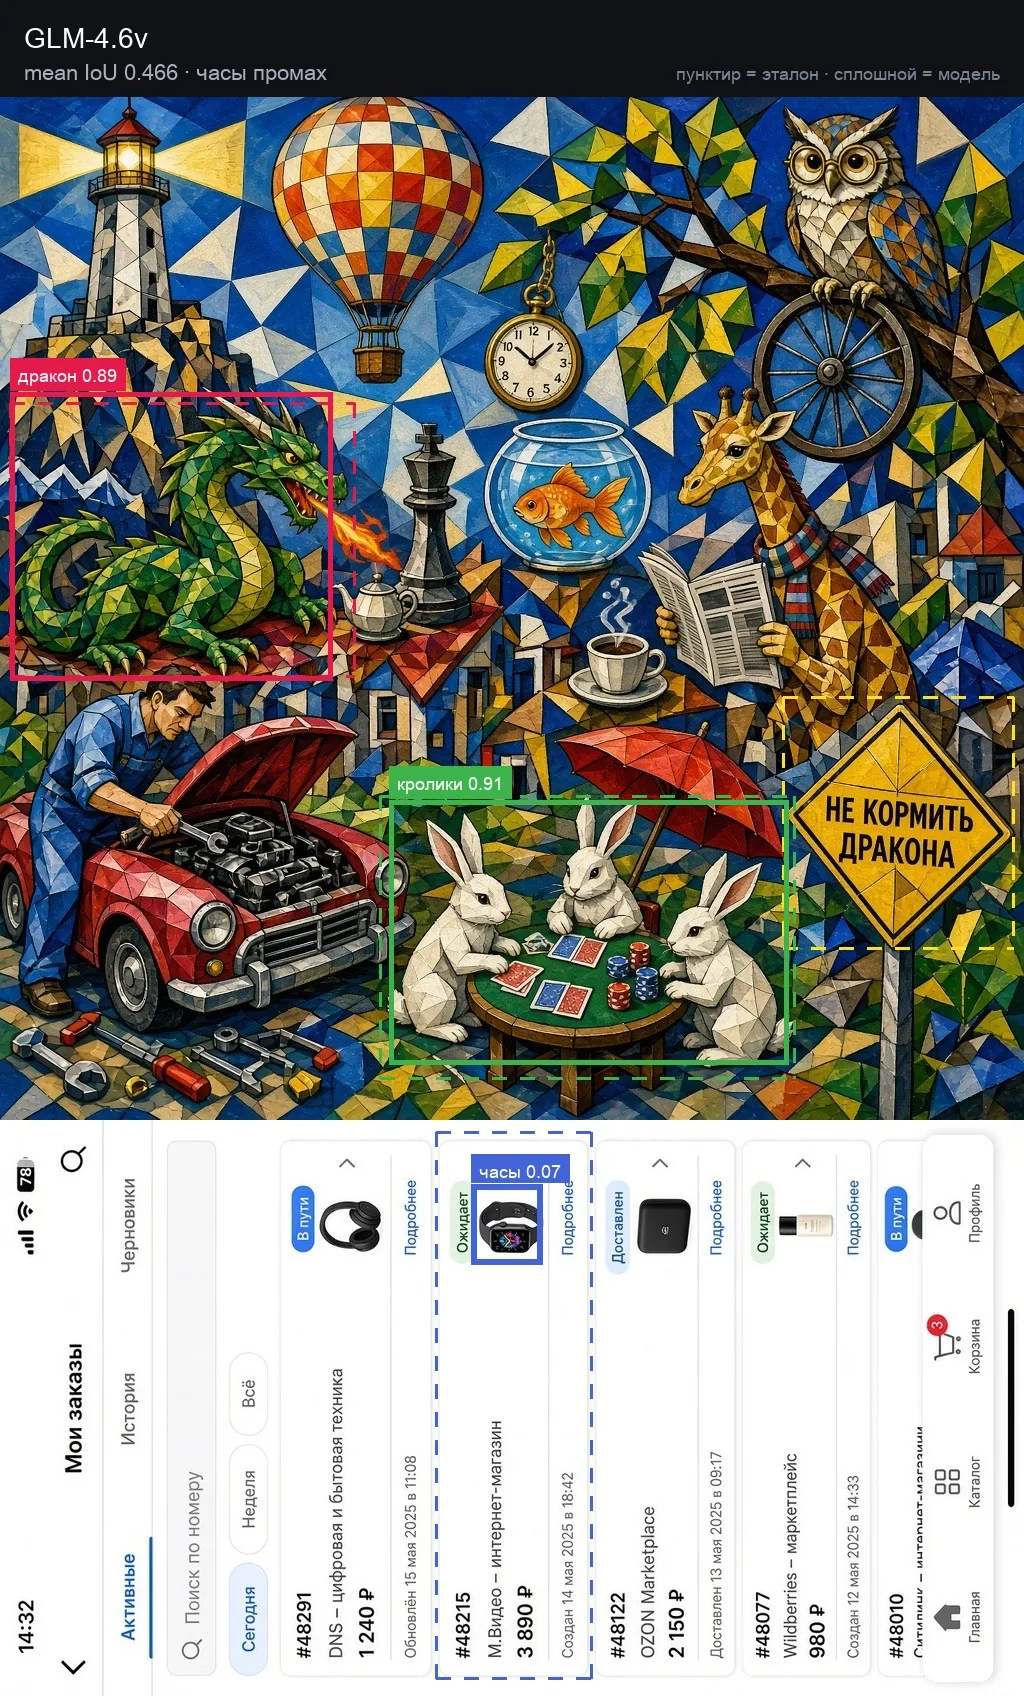
GLM-4.6v силён на «животных» сценах (дракон и кролики около 0.9), но часы в UI почти не ловит — бокс сжимается в крошечный квадрат.
Слабее локализация у Opus, Maverick, Haiku, Grok и части моделей, которые на describe были сильными: Sonnet и Scout на боксах фактически обнулились — ответ не разобрался в нужный JSON или боксы не попали в цели. Мелкий знак так и остался самым капризным объектом.
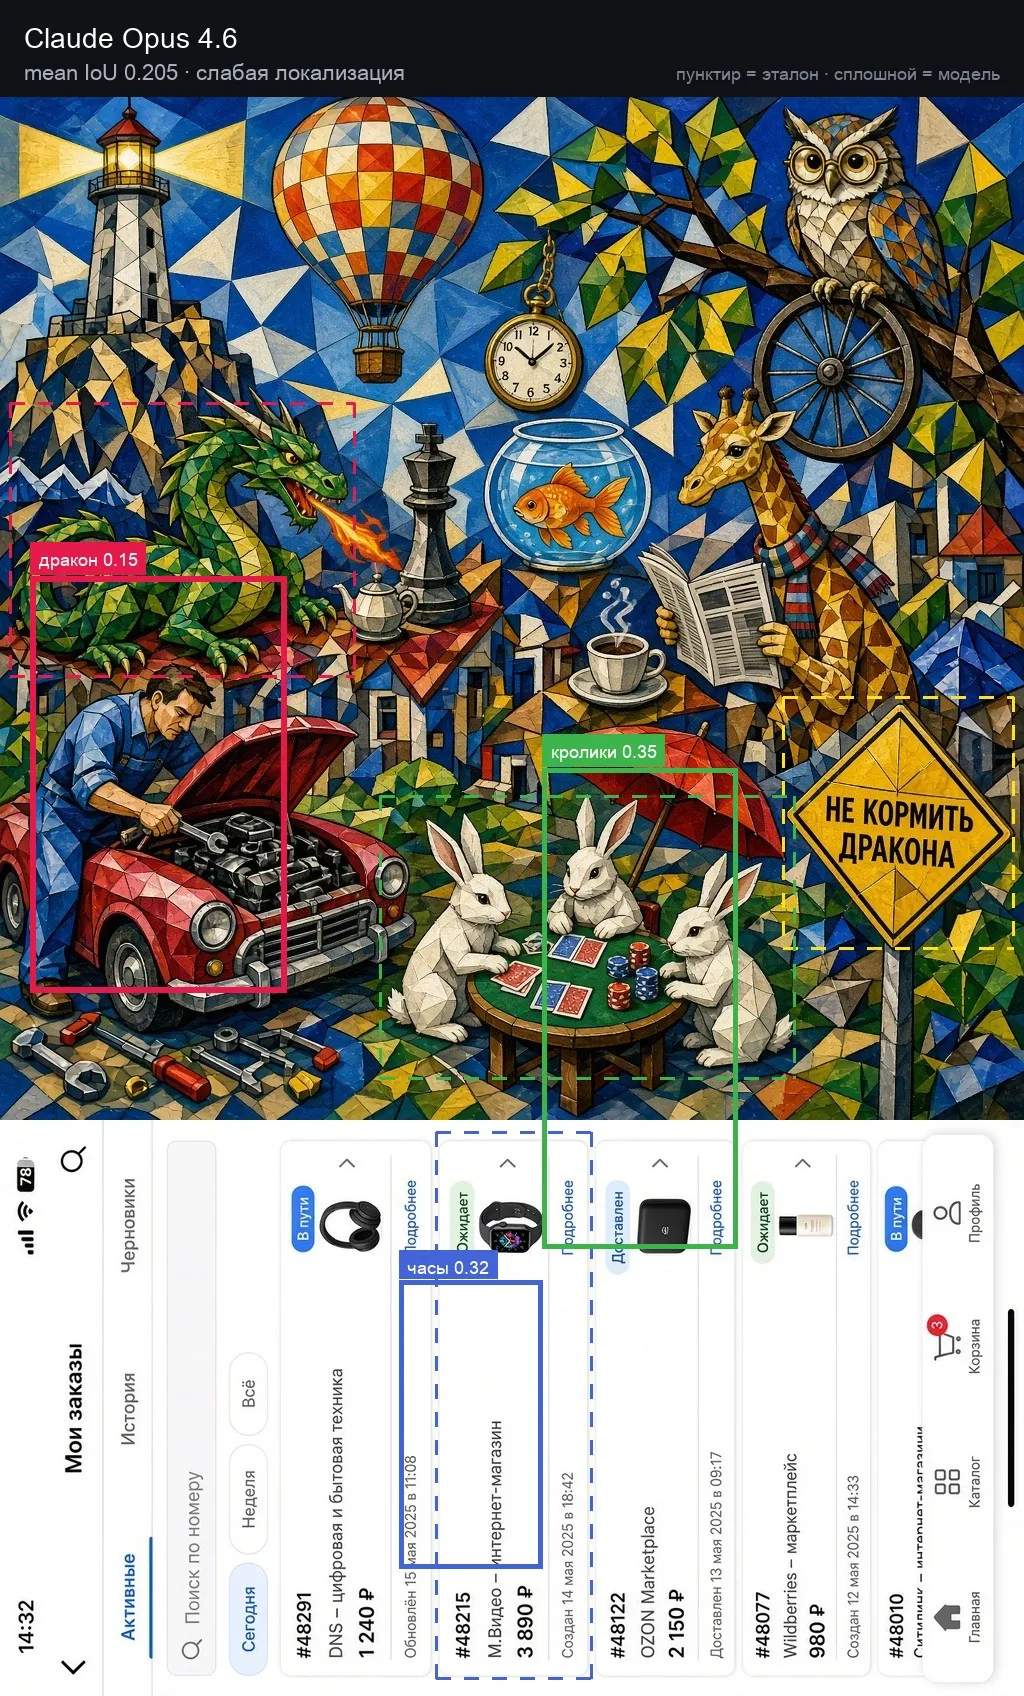
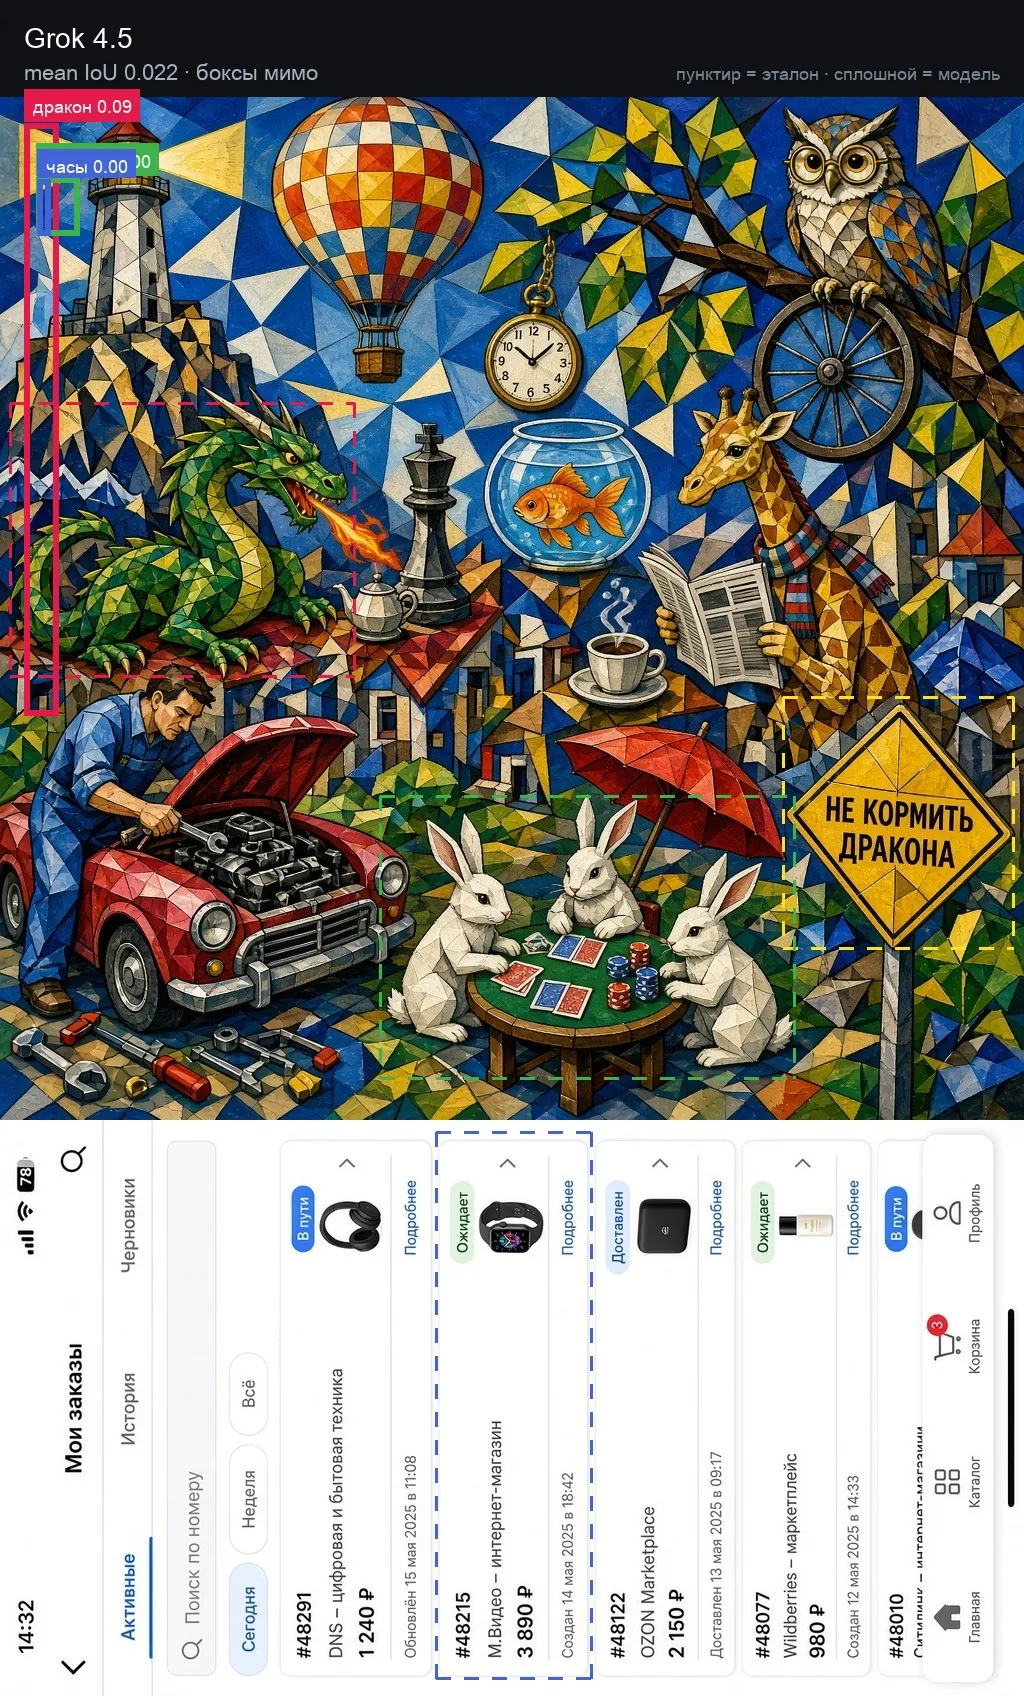
Opus на describe закрыл чеклист на 15/15, а на ground mean IoU всего 0.205. Grok тоже полный describe, но боксы уехали в угол кадра.
Describe и ground — разные навыки. Модель может идеально пересказать кашу и при этом промахнуться боксом по нужной строке заказа.
Что брать в работу
Если в продукте нужен осмотр референса — скрина сайта, кадра ролика, коллажа — берите сильные и дешёвые: DeepSeek Flash, Qwen3-VL 8B/30B, Gemini Flash-Lite. Они закрывают чеклист наравне с топами.
Если нужны боксы — «выдели вот этот объект / вот эту плашку» — смотрите на Gemini 3.5 (включая Lite), Sol, Qwen 8B, Luna и DeepSeek Flash. Mean IoU у них в зоне 0.55–0.69, а UI-цель с часами они берут уверенно.
Не стоит выбирать модель только по ценнику сверху вниз. Opus отлично пишет текст, но в ground-тесте уступил гораздо более дешёвым vision-специалистам. И наоборот: самый дешёвый ответ не всегда умеет координаты.
Итог
Мы взяли одну жёсткую картинку, два простых промпта и двадцать моделей — и получили ровную картину.
На свободном описании Flash и VL закрывают чеклист рядом с флагманами.
На локализации лидируют Gemini 3.5, Sol, Qwen 8B, Luna и DeepSeek Flash.
Поворот UI и мелкий знак — всё ещё узкие места даже у сильных.
Осмысленный сравнительный пакет на такую сетку стоит порядка двадцати центов.
Шпаргалка простая: сначала «что видишь», потом «обведи вот это» — и смотри на цифры, а не на название в прайсе. Модели меняются быстро; метод остаётся тем же.